 Agent View
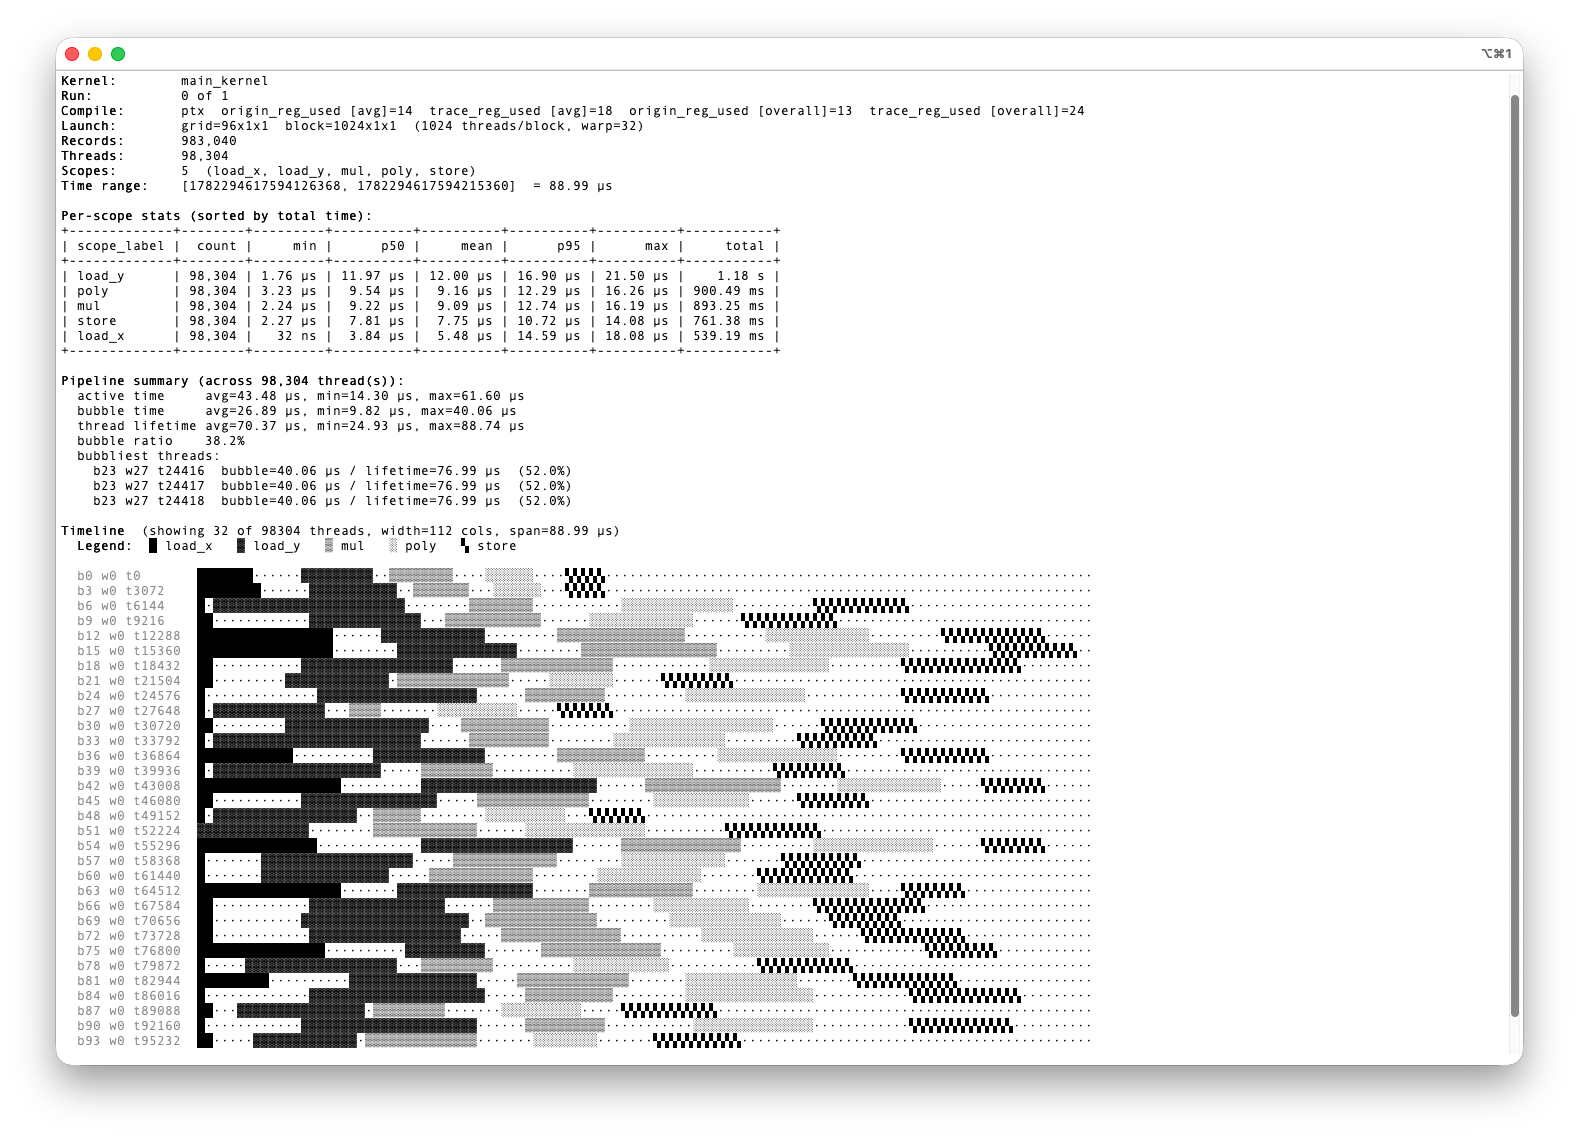
核内追踪 (Xtrace)
看清单次 kernel 内部的 phase 时间线:load、compute、epilogue,以及它们之间的气泡。在 CUDA、TileLang、CuTeDSL 或 Triton 里打 scope,然后以人类报告或 agent 视图查看追踪结果。
基于计数器的剖析
Range profiling 按每次 launch 采集硬件计数器——占用率、pipe/tensor core 利用率、访存吞吐、达成-对-峰值的 cycle 比;PC 采样进一步把瓶颈定位到具体 stall 的指令及其原因(访存等待、依赖、分支发散、throttle),并映射到源码与 SASS。
二进制分析
检视编译器生成的 SASS/AMDGPU 二进制:反混淆 kernel 名、遍历反汇编指令、映射 PC→源码行、导出控制流图与基本块——用于寄存器分析与二进制插桩。
面向智能体的自动优化
以 agent skill 形式提供,驱动推理闭环:剖析 → 提出假设 → 施加一处最小改动 → 验证正确性、性能与硬件行为。支持 CUDA C++、Triton、CuTe、TileLang 与 HIP。
快速开始
一分钟安装
装上包与 agent skill,然后直接让你的智能体去剖析一个 kernel。
$ pip3 install gwatch$ npx skills add mars-compute-ai/G-Watch -g
- 1
安装 G-Watch
pip3 install gwatch从 PyPI 拉取剖析 + 程序分析工具箱。 - 2
安装 agent skill
npx skills add mars-compute-ai/G-Watch -g把 G-Watch skills 全局分发给你的编程智能体。 - 3
向智能体提问
例如
加载 gwatch intra-kernel tracing skill,追踪 bench.py 里的 matmul kernel——智能体会完成剖析并写出报告。
G-Watch 支持 NVIDIA、AMD GPU 与 Google TPU。各平台的具体配置见文档。